Linux cgroup 资源控制 #
cgroup(control group,控制组)是 Linux 内核用来按组组织进程,并统计、限制或分配系统资源的机制。它常与 namespace、capabilities、seccomp 等机制一起构成容器运行环境,但 cgroup 本身不负责隔离进程可见的 PID、网络或挂载视图。
本篇以 cgroup v2 为主线,也解释 v1 的多层级模型。建议先记住三点:cgroup 是资源管理层级,不是进程父子树;父级约束会限制后代;资源限制不等同于预留。 接口是否可用还取决于内核、挂载方式、systemd、运行时和权限,排障时以实际节点为准。
1. cgroup 和容器的关系 #
| 机制 | 主要作用 | 例子 |
|---|---|---|
| cgroup | 按进程组做资源记账和资源控制 | CPU 配额、内存限制、任务数、块设备 I/O 控制 |
| namespace | 限制进程能看到的资源和名称空间 | PID、mount、network、cgroup namespace |
| capabilities / LSM | 控制特权操作和安全边界 | 限制容器进程可执行的管理操作 |
| seccomp | 限制系统调用 | 拒绝特定 syscall |
容器是这些机制、文件系统和用户态运行时的组合。cgroup 不会自动隐藏主机进程,也不单独构成完整的安全隔离边界。
2. 核心对象与内核数据结构 #
- task:内核调度和管理的任务。传统 cgroup 文档常用 task 泛指进程/线程;用户态接口通常使用 PID 或 TID。
- process / thread:一个进程可以包含多个线程。v1 的
tasks接口可单独迁移线程;v2 默认按进程管理,但 threaded 子树支持特定控制器下的线程级组织。 - cgroup:层级树中的一个节点,包含进程成员关系和控制器接口。
- controller:统计或控制特定资源的内核组件,例如
cpu、memory、io、pids、cpuset。 - hierarchy:cgroup 节点组成的一棵树。v1 可有多棵分别关联控制器的树;v2 使用单一统一树。
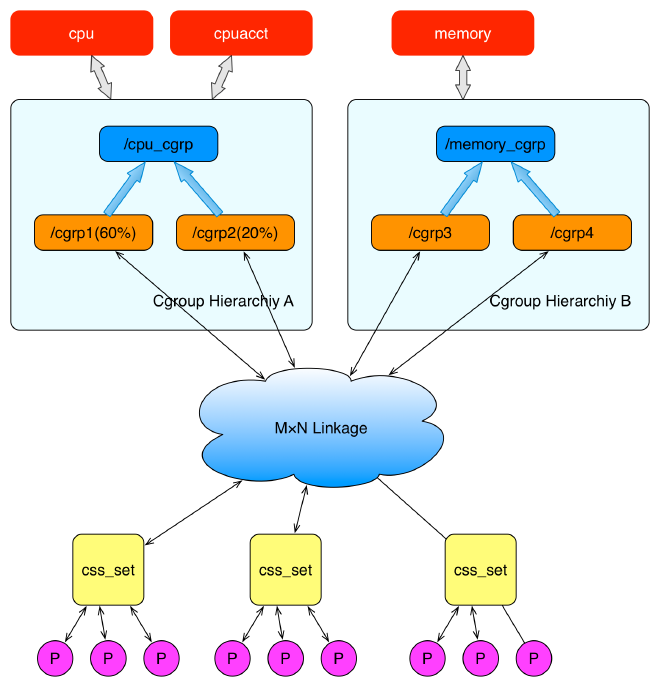
- css_set:内核把 task 与各控制器状态关联起来的内部结构。每个 task 关联一个
css_set,多个 task 可以共享一个;在 v1 多层级环境中,它组合了该 task 在不同 hierarchy 中的 cgroup 状态。
每个 v1 hierarchy 中,一个 task 属于该树中的一个 cgroup;同一 task 可以在不同 hierarchy 中分别归属不同 cgroup。v2 中,所有进程位于统一的 cgroup 树。创建子进程时,子进程通常进入创建者当时所在的 cgroup。
下图展示 v1 的概念关系:控制器层级通过 css_set 关联到 task。CPU 组上的百分比是权重关系的示意,不能当作固定 CPU 配额或保证值。
3. v1 的多棵树与 v2 的统一树 #
3.1 v1:控制器可以用不同方式分组 #
v1 允许多个 hierarchy。一个 hierarchy 可以挂一个或多个控制器;同一个控制器不能同时任意绑定到多棵活动 hierarchy。这样,管理员可以按资源种类组织不同层级。例如 CPU 按工作类型分组,内存按服务分组:
CPU hierarchy                   Memory hierarchy
cpu-root                        memory-root
├── batch                       ├── service-a
│   ├── PID 101                  │   ├── PID 101
│   └── PID 202                  │   └── PID 303
└── interactive                 └── service-b
    └── PID 303                      └── PID 202
PID 101 在 CPU 树和内存树中的成员关系不同;进程没有被复制。这种灵活性也带来复杂性:查看一个 task 时,必须分别理解它在每棵 hierarchy 的位置。
3.2 v2:单一层级,控制器逐层启用 #
v2 将资源控制器统一到一棵树中。父 cgroup 通过 cgroup.subtree_control 向子节点启用控制器,子节点只有拿到父层传下来的控制器后,才能继续向下一层分配资源。某些过渡系统仍会同时挂载 v1 和 v2:这是混合模式,不代表 v2 自己有多棵统一层级。
统一层级(cgroup v2)
/
└── system.slice
    └── app.slice                 ← 父组资源边界
        ├── api.service           ← API 进程及其线程
        └── worker.service        ← Worker 进程及其线程
假设 app.slice 的 CPU 配额约为 4 CPU,API 子组上限为 2 CPU,Worker 子组上限为 3 CPU。两个子组各自可能用到自己的上限,但同时运行时,总量仍受父组约 4 CPU 的约束。子组限制只能进一步收紧,不能突破祖先边界。
3.3 v1 与 v2 的主要区别 #
| 方面 | v1 | v2 |
|---|---|---|
| 层级 | 可有多个 hierarchy,按控制器组合挂载 | 一棵统一 hierarchy;系统可在迁移期间与 v1 混用 |
| 文件接口 | 文件名、行为因控制器和历史接口而异 | 统一核心接口,控制器向子树逐层启用 |
| 进程归属 | 每棵 hierarchy 各有一个 cgroup 归属 | 通常在统一树中只有一个 cgroup 归属 |
| 线程迁移 | tasks 移单个 task;cgroup.procs 移整个线程组 |
默认 cgroup.procs 移整个进程;threaded 子树可用 cgroup.threads 移线程 |
| 层级约束 | 控制器可以有不同的分组结构 | 父级约束递归作用于子树,并有无内部进程等规则 |
4. 检查当前系统 #
stat -fc %T /sys/fs/cgroup
findmnt -t cgroup,cgroup2
cat /proc/self/cgroup
/sys/fs/cgroup 类型为 cgroup2fs、且 /proc/self/cgroup 出现 0::/path,通常表示该进程使用 v2。v1 环境通常会在 /proc/self/cgroup 中看到控制器名称和多行层级。/proc/cgroups 是 v1 时代的信息,在 v2 中不能用来确认控制器挂载布局。
容器里的 cgroup namespace 可能把路径显示成相对自身根目录的形式;容器内路径不一定是主机上的绝对路径。要查主机实际归属,还需结合主机上的 /proc/<pid>/cgroup、挂载信息和运行时。
5. v2 层级规则和核心文件 #
5.1 控制器逐层向下启用 #
cgroup.controllers:列出当前 cgroup 可供其子节点启用的控制器。cgroup.subtree_control:列出当前节点已经启用、用于控制子节点资源分配的控制器。- 在适当父节点写入
+cpu +memory等操作,才会向子组暴露相应控制器接口;子组如需继续向下分配,还需要在自己的cgroup.subtree_control中启用。 - 一次写入包含多个启用/禁用操作时,内核要么全部应用,要么全部失败;同一控制器出现多次时,最后一次操作生效。
**无内部进程规则:**非根 domain cgroup 要把域控制器启用给子节点时,通常不能同时直接容纳进程。常见结构是让父组承担管理和资源分配,工作负载放进子组。threaded 子树有单独规则。
5.2 常见核心文件 #
| 文件 | 作用与注意事项 |
|---|---|
cgroup.procs |
列出当前组的进程 PID;写入 PID 会迁移该进程的所有线程。每次写入迁移一个进程。 |
cgroup.threads |
列出线程 TID;只能在同一 threaded resource domain 中按线程迁移。 |
cgroup.type |
显示 domain、threaded 等类型;新组默认是 domain。 |
cgroup.events |
非根组常见接口;populated 表示本组或后代是否有活动进程,frozen 表示冻结状态。 |
cgroup.freeze |
非根组的冻结开关;冻结可能需要时间,完成状态查看 cgroup.events。冻结是暂停运行,不是杀进程。 |
cgroup.kill |
非根组的只写接口;写入 1 会对本组及后代进程发送 SIGKILL,不是删除 cgroup。 |
cgroup.max.descendants |
限制当前组下可创建的后代 cgroup 数量。 |
cgroup.max.depth |
限制当前组下面允许的最大层级深度。 |
cgroup.stat |
提供后代及控制器状态统计;字段依内核版本而异。 |
文件是否存在,取决于内核版本、控制器支持与启用状态、所在层级和权限。不要把某台机器的文件列表当成所有 Linux 内核都固定不变的接口。
6. 进程迁移 #
迁移是改变进程的 cgroup 成员关系,不是重启进程或改变其父子关系。v1 中每个 task 在每棵活动 hierarchy 各有一个归属,因此将 PID 写到某棵树的目标组,只改变该 hierarchy 的归属。v2 通常通过目标组的 cgroup.procs 迁移整个进程及其线程;具备 threaded 结构时,cgroup.threads 才能按线程迁移。
# 示例:需要对目标组有写权限,并且来源/目标均在允许管理的子树中
echo 1234 > /sys/fs/cgroup/app-b/cgroup.procs
已有子进程不会随父进程迁移;之后由它创建的新进程通常继承创建者的新 cgroup。v2 中,已分配的内存页等有状态资源不会随进程迁移,仍可能计在原 cgroup;频繁迁移来切换限制不是推荐的治理方式。应尽量在进程启动时放入正确组,运行中需要调整时优先修改控制器配置。
迁移可能因权限、委派边界、控制器条件或层级规则而失败。不要在 systemd 或容器运行时管理的子树里擅自写文件;应由对应管理器执行迁移或明确委派该子树。
7. 常用资源控制器 #
7.1 CPU #
配额:CPU 时间上限 #
v1 使用 cpu.cfs_quota_us 和 cpu.cfs_period_us;v2 使用 cpu.max,格式为 MAX PERIOD,单位为微秒。比如 200000 100000 代表每 100ms 最多累计使用 200ms CPU 时间,约等于 2 个 CPU 的带宽上限。max 100000 表示该组不设 quota 上限。
这不是绑定两个特定核心,也不是保证随时得到两个核心。父组也可能先耗尽配额,使子组即使自身尚有预算仍被节流。并行度、CPU affinity/cpuset、周期、突发设置和祖先配额都会影响观察到的节流时机。
权重:竞争时的相对份额 #
v1 的 cpu.shares 和 v2 的 cpu.weight 用于同级可运行组竞争 CPU 时的相对分配;它们不是硬上限,也不保证一个固定百分比。v2 cpu.weight 常见默认值为 100,有效范围通常为 1–10000。仅有竞争时才体现相对权重。
观测 #
- v1:
cpu.stat的nr_periods、nr_throttled、throttled_time等字段。 - v2:
cpu.stat,以及支持时的cpu.pressure;注意cpu.stat的分层统计字段与cpu.stat.local语义不同。
7.2 内存 #
常见 v2 文件包括:
memory.current:当前组及其子树的计费用量。memory.high:高水位。超过后会施加回收压力和分配节流;它本身不触发 OOM killer,数值也可能暂时被突破。memory.max:硬上限。内核会尝试回收;无法满足分配时可能在该 cgroup 中触发 OOM 处理。memory.min、memory.low:内存回收中的保护语义,受祖先保护额度及 overcommit 影响,不等于独占预留。memory.swap.max:限制组可使用的 swap(如内核和系统配置支持)。memory.events:记录high、max、oom、oom_kill等事件。默认会包含子树计数;挂载选项memory_localevents可改变这一统计行为。memory.stat、memory.pressure:提供分类统计和内存压力信息(字段依内核而异)。
memory.current 不等于各进程 RSS 的简单求和:页缓存、共享页、后代记账和内核记账都可能造成差异。v2 中,内存区域通常记在创建它的 cgroup,直到区域释放;迁移进程不自动搬走旧的内存账目。因此判断 OOM 时要同时查看目标组和祖先组、memory.events、内核日志,以及运行时事件,区分 cgroup OOM、主机 OOM 和 Kubernetes eviction。
7.3 PIDs #
pids.max 限制该组可创建的任务数量,线程也计入。达到限制时,fork() 或 clone() 可能失败并返回 EAGAIN。用 pids.current、pids.events 排查线程/进程创建失败;祖先的 PID 限制同样会影响后代。
7.4 I/O #
v2 io.max 按块设备 major:minor 设置读写字节速率(B/s)或 IOPS 上限,io.stat 用于观测。io.weight 是相对权重。效果取决于内核、设备、I/O 调度器和文件系统栈;先核对设备号与真实底层设备,不能只凭容器路径判断。
7.5 cpuset #
cpuset.cpus 限定允许运行的 CPU 集合,cpuset.mems 限定 NUMA 内存节点。它们与 CPU quota 不同:前者限制“可以在哪些 CPU 上运行”,quota 限制“单位时间最多使用多少 CPU 时间”。集合必须满足父级约束并包含在线资源。
其他控制器包括 hugetlb、rdma、misc 等,取决于内核配置和平台。不要假设 v1 的每个控制器都在 v2 中有同名、完全等价的接口。
8. systemd、容器与 Kubernetes #
现代 Linux 上 systemd 通常是 cgroup 树的管理者。服务、scope 和 slice 对应树中的组。检查层级可用:
systemd-cgls
systemctl show nginx.service -p ControlGroup -p CPUQuotaPerSecUSec -p MemoryHigh -p MemoryMax -p TasksMax
服务资源限制应优先通过 systemd unit 属性(例如 CPUQuota=、CPUWeight=、MemoryHigh=、MemoryMax=、TasksMax=)配置,并以本机 systemd.resource-control(5) 的版本为准。需要让容器管理器在服务组下自行建立子 cgroup 时,应使用 Delegate=;systemd 与容器管理器不要同时写同一个 cgroup 子树。
Docker、containerd、CRI-O 等运行时会把 OCI 资源设置映射到内核 cgroup。Kubernetes request 主要用于调度和 QoS/份额决策,limit 通常映射为内核资源上限;具体行为受版本、运行时、cgroup 版本和 kubelet 配置影响。内存超限导致的 cgroup OOM 与 kubelet 基于节点压力触发的 eviction 是不同事件。
9. 实操与排障顺序 #
9.1 先读取现状 #
cat /proc/self/cgroup
findmnt -t cgroup,cgroup2
cat /sys/fs/cgroup/cgroup.controllers 2>/dev/null
cat /sys/fs/cgroup/cgroup.subtree_control 2>/dev/null
在容器内执行时,路径可能经过 namespace 映射;文件不存在也可能是控制器没启用、没委派或挂载只读。
9.2 按症状定位 #
| 症状 | 先看什么 | 常见原因 |
|---|---|---|
| CPU 延迟、使用率不高却卡顿 | 当前及祖先组 quota、cpu.stat throttling、CPU pressure、cpuset |
父级配额耗尽、周期预算已耗尽、同级竞争或 CPU 集合过小 |
| 进程突然被杀 | memory.events、memory.max/high、祖先内存限制、内核日志、容器事件 |
cgroup OOM 或主机级 OOM;也需与 kubelet eviction 区分 |
| 创建线程失败 | pids.current/max/events、系统调用 errno、祖先限制 |
PID controller 触顶,通常返回 EAGAIN |
| 磁盘变慢 | io.max、io.stat、块设备 major:minor、主机 I/O 延迟 |
I/O 限速、设备映射不符或底层存储拥塞 |
| 控制器文件缺失/写入失败 | 版本、挂载、cgroup.controllers、父级 cgroup.subtree_control、权限和委派 |
控制器不可用/未启用、管理权不在当前进程或违反层级规则 |
按这个顺序排查通常更快:确认进程实际所在路径 → 判断 v1/v2 与挂载 → 看当前组和祖先限制 → 读计数器/pressure → 查 systemd/运行时配置 → 在测试环境验证。
10. 常见误区 #
- 容器就是 cgroup。 容器还需要 namespace、权限控制、文件系统和运行时等机制。
- CPU quota 是固定绑核。 quota 是 CPU 时间预算;CPU 集合看 cpuset/affinity。
- CPU weight 是保底或硬限制。 它是竞争条件下的相对权重。
- v2 的每个线程都必须处在同一个 cgroup。 默认如此;threaded 子树是例外。
- 父组参数都会复制给子组。 父级约束会影响后代,但每个控制器具体的默认和继承语义不同。
- 迁移进程会把所有资源账目一起转移。 尤其 v2 内存页账目不会因为进程迁移而自动搬迁。
- 在容器内看到的 cgroup 路径就是主机路径。 cgroup namespace 可能重映射视图。
- 手动改文件就是永久配置。 systemd 或运行时可能重新协调或覆盖;生产策略应在实际管理者处设置。
11. 常见问题与参考回答 #
基础 #
1. cgroup 是什么?与 namespace 有何区别?
cgroup 按组统计和控制资源;namespace 隔离资源的可见范围和名称空间。容器经常把两者组合起来。
2. cgroup 层级是否等同于进程树?
不是。它是资源管理树;进程由管理器放入组中,和进程父子关系独立。迁移父进程不会递归迁移已有子进程。
3. v1 的多棵树有什么意义?
能按不同资源采用不同分组,例如 CPU 按工作类型划分,内存按服务划分;代价是成员关系、路径和管理更复杂。
4. v1 与 v2 的核心区别?
v1 可以有多棵关联不同控制器的 hierarchy;v2 使用统一层级、控制器向子树逐层启用,并引入更明确的层级和委派约束。
5. cgroup.controllers 和 cgroup.subtree_control 有何区别?
前者列出当前节点可供子节点启用的控制器;后者列出当前节点已经启用来控制子节点资源分配的控制器。
6. v2 的无内部进程规则是什么?
非根 domain cgroup 要启用域控制器向子组分配资源时,通常不能同时直接承载进程;把工作负载放到子组是常见方案。threaded 子树有专门规则。
资源控制 #
7. cpu.max 如何计算?
MAX PERIOD 是每周期的 CPU 时间预算。比如 200000 100000 等价于约 2 个 CPU 的带宽上限,但不是固定两颗核心。
8. CPU quota 与权重有何区别?
quota 是硬带宽上限;weight 是同级竞争时的相对分配。没有竞争时,权重可能不体现效果。
9. 4 CPU quota 为什么会发生 throttling?
进程可并行消耗多个 CPU;当一个周期内累计预算耗尽,组会被限制到下个周期补充。祖先 quota 也可能先耗尽。检查本组与祖先组的配额、cpu.stat 和压力指标。
10. memory.high 和 memory.max 的区别?
high 超限会施加回收压力和节流,不会直接触发 OOM killer;max 是硬边界,回收无法满足分配时可能发生组内 OOM。
11. 为什么 RSS 之和不等于 memory.current?
共享页、页缓存、内核记账、后代统计和进程采样时差会造成差异;迁移进程也不会自动搬迁既有内存页账目。
12. pids.max 限制进程还是线程?
限制 task 数,线程也计入。触顶时 fork/clone 常见返回 EAGAIN。
13. cpuset 和 quota 区别?
cpuset 限定可运行在哪些 CPU 上,quota 限制单位时间内的 CPU 时间预算。
14. 如何确认是 cgroup OOM?
结合该组和祖先组的 memory.events、内核 OOM 日志、容器运行时事件及 kubelet 事件,区分组内 OOM、主机 OOM 与 eviction。
容器和排障 #
15. Kubernetes 的 CPU request 与 limit 分别是什么?
request 主要参与调度和相对资源配置;limit 通常映射为 CPU quota。具体映射随 kubelet、运行时和 cgroup 版本而异。
16. 为什么容器里没有 memory.max?
可能仍是 v1、memory controller 未编译/未挂载/被绑定到 v1、v2 父级未启用、容器没有委派权限,或挂载只读。
17. 为什么手动修改的值被覆盖?
该 cgroup 归 systemd 或容器运行时管理。应由树的所有者通过其配置接口设置,避免多个写入者互相覆盖。
18. 如何委派 cgroup 子树?
由 systemd 等管理器明确对 service/scope 开启 Delegate=,只在委派的子树操作,并遵守父级限制、控制器启用顺序和单写入者规则。
19. 容器内路径为何与宿主机不一样?
cgroup namespace 和 mount namespace 会改变可见路径;需结合宿主机上的 /proc/<pid>/cgroup 及运行时信息映射。
20. 为什么不建议频繁迁移进程?
迁移有同步和记账开销,有状态资源(尤其已计费的内存)不会一起移动;更适合在启动时确定工作负载归属,运行中调整时优先修改控制器参数。
12. 官方资料 #
- Linux Kernel cgroup v2 文档:统一层级、核心接口、控制器、迁移、委派和内存记账。
- Linux Kernel cgroup v1 概述:多层级、
tasks/cgroup.procs和 v1 背景。 - Linux Kernel CFS 带宽控制:v1 quota/period、节流统计、层级配额与 burst。
- systemd cgroup 委派说明:systemd 与容器管理器的 cgroup 子树边界。
内核接口、systemd 属性和容器运行时映射会随版本与配置变化;生产排障应优先检查当前节点的真实文件和管理器配置。